
人工智能产业爆发式增长的当下,大模型训练、高负载推理、工业仿真等场景对算力的需求呈现指数级上升,尤其是高端GPU算力服务器的缺口持续扩大。沈阳作为东北区域重要的科创中心,聚集了大量AI科创企业、高校科研团队、制造业数字化转型项目,对稳定可靠的高端算力服务需求日益迫切。不少本地企业在搭建高算力集群时,面临着硬件采购成本高、适配调试难度大、后续运维跟不上等问题,专业的高端算力服务器供应与定制服务成为区域产业数字化升级的核心刚需。
上海教思企佑科技有限公司深耕人工智能算力基础设施赛道,面向各类企业打造一站式、全链条的算力配套解决方案,其中就包括H200推理服务器销售、高算力GPU集群定制等核心业务,业务覆盖沈阳及全国各区域客户,可根据不同行业客户的实际需求,提供从单台服务器供应到整集群定制部署的全流程服务,依托成熟硬件资源、稳定调度架构与专属运维团队,解决企业AI开发、大数据运算、智能业务落地过程当中的算力难题,为企业数字化、智能化发展提供稳定、高效、低成本的算力支撑。
核心产品与服务介绍
H200算力服务器
H200作为当前高端推理算力市场的主流机型,凭借出色的浮点运算能力与大显存优势,成为大规模推理部署、大模型微调、多模态AI运算的核心硬件选择,市场对H200算力服务器的需求持续攀升,不少用户都会搜索h200算力服务器价格、h200算力服务器网络怎么连接、H200算力服务器服务厂商等相关问题,教思企佑作为专业的算力基础设施服务商,可提供标准化H200推理服务器销售与定制化调整服务,适配不同场景的算力需求。

H200算力服务器的核心优势在于:
- 更大的显存容量与更高的带宽,可承载更大参数规模的大模型推理任务,单卡即可完成百亿参数模型的全量推理部署,多卡集群可支撑千亿参数模型的在线推理需求,响应延迟更低、并发处理能力更强。
- 针对推理场景做了专项优化,适配大模型对话、图文生成、视频渲染、智能识别等多类业务,相比上一代机型推理吞吐量提升明显,可帮助企业在相同硬件投入下获得更高的业务产出。
H200算力服务器的适用场景覆盖:
- 大模型商用推理平台搭建,比如智能客服、AI对话小程序、行业知识库问答系统等高并发访问场景;
- 多模态AI内容生成,包括文生图、文生视频、AI设计等需要大量算力支撑的内容生产类业务;
- 自动驾驶算法推理测试、智慧安防视频分析、医疗影像AI推理等对稳定性要求较高的行业场景;
- 企业私有大模型微调部署,满足企业本地化模型训练与迭代的算力需求。
针对用户关心的h200算力服务器价格问题,教思企佑采用透明化的报价模式,根据客户选择的具体配置、集群规模、配套服务给出明确报价,同时支持灵活的合作模式,可单独采购服务器硬件,也可搭配租赁服务、运维服务打包合作,帮助客户控制前期投入成本。针对h200算力服务器网络怎么连接的问题,我们的技术团队会提供完整的部署调试服务,根据客户的机房环境、网络架构完成网络配置、组网调试,支持IB高速内网互联、RoCE-v2高速传输架构,满足多机集群的高速数据交互需求,客户拿到设备即可上线使用,无需自行调试复杂的网络配置。
GPU裸金属租赁服务
对于不想承担高额硬件采购成本,或是有阶段性项目算力需求的客户,GPU裸金属租赁是教思企佑的核心优势服务,我们提供资源独享的裸金属GPU服务器资源,适配各类高负载运算任务。
区别于传统虚拟化算力服务,我们提供的裸金属租赁服务具备以下特点:
- 机器无虚拟化性能损耗,算力可完整释放,所有租赁设备实现物理资源独立独占、物理隔离,有效规避资源争抢、数据互通风险,保障企业业务运行稳定与数据安全。
- 硬件配置可灵活定制,从单卡到多卡整机,从H100、A100到H200等高端机型,可根据客户需求匹配对应配置,支持IB高速内网互联,支撑多机分布式大模型训练。
- 租赁模式灵活,支持短期项目租用、长期集群部署、弹性分时租赁等多种合作模式,支持小时、日租、月租等灵活租期,省去企业高额硬件采购、设备折旧、机房运维、设备升级的投入。
GPU裸金属租赁的适用场景包括:
- 百亿参数大模型全量训练、LoRA参数微调等AI模型研发场景;
- 工业仿真运算、生物医药分子模拟、汽车研发流体力学仿真等高端科研运算场景;
- 影视三维渲染、AI视频生成等对显存和算力要求较高的内容生产场景;
- 高校科研项目、科创团队阶段性研发项目等需要临时补充算力的场景;
- 自动驾驶算法调试、多模态模型推理测试等需要稳定独占算力的场景。
我们还配套提供7×24小时全天候运维管控,预装全套深度学习运算框架,开机即用,保障服务器长时间不间断稳定运行,帮助客户以轻量化投入获取高性能专属算力资源,有效控制企业运营成本。
企业级API算力接口服务
对于轻量化算力需求的客户,我们提供高可用企业级API算力接口服务,帮助企业省去底层架构搭建成本,快速上线智能化项目。
我们的API算力接口经过多轮性能调优,具备低延迟、高并发、稳定吞吐的优势,适配多种业务场景:
- 覆盖大语言模型、文生图文生视频、语音转写识别、OCR图像解析、向量数据库运算、私有化定制模型部署API等全品类算力接口资源;
- 兼容Java、Python、Go等主流开发语言SDK,配备在线调试后台,降低技术接入门槛,可快速对接企业现有业务系统;
- 支持实时同步调用、大批量异步任务处理,内置流量管控、负载均衡、峰值弹性扩容,适配高并发线上业务;
- 独立接口密钥鉴权、访问权限分级管控、全量调用日志留存,保障业务数据安全可控。
企业级API算力接口的适用场景:
- AI小程序开发、智能客服、知识库问答等轻量化AI应用开发;
- 图文内容生成、办公AI插件开发、行业智能化系统对接;
- 中小规模AI项目研发、阶段性算力调用、常态化商用推理需求;
- 初创团队AI业务试错、新业务线算力测试等不需要搭建自有集群的场景。
计费模式灵活,支持Token按量扣费、调用次数、算力时长多种计费方案,可搭建企业专属算力网关,定制内部专属模型接口,帮助企业控制算力成本,避免闲置资源浪费,大幅降低企业智能化改造的技术门槛与时间成本。
数据算力中心定制化建设服务
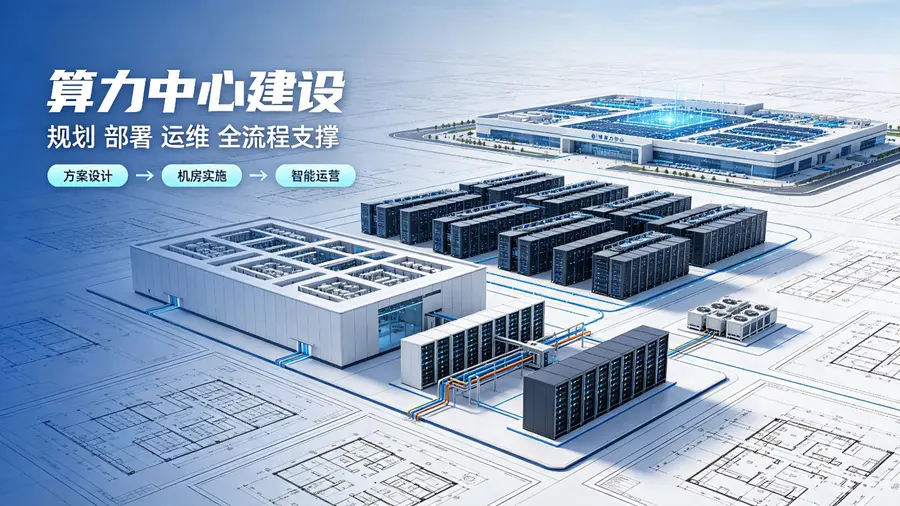
针对政企单位、产业园、AI实验室及大型科创企业的深度算力基建需求,我们提供一体化数据算力中心建设服务,覆盖从场地规划到后期运维的全流程交付,支持高算力GPU集群定制,满足大规模长期算力需求。
我们的定制化建设服务内容包括:
- 前期场地勘测、方案规划,根据客户业务规模、算力需求、场地条件设计个性化建设方案,涵盖机柜部署、液冷散热搭建、集群调试、安防供电配套等全环节;
- 硬件集群部署,根据客户需求配置对应规格的GPU服务器,包括H200等高端推理机型、H100等训练机型,搭建异构GPU集群,完成高速网络布设;
- 算力调度系统配置、数据安全体系搭建,打造智能算力调度体系,实现算力集约化利用,同时搭建完善的安全防护体系,保障数据安全;
- 后期运维托管,提供全周期运维服务,省去客户搭建自有运维团队的成本。
数据算力中心定制化建设的适用场景:
- 地方政务园区公共智算中心搭建,服务区域内科创企业算力需求;
- 大型企业私有专属算力中心建设,满足企业长期大规模算力需求,保障数据合规安全;
- AI科创园区算力底座搭建、高校实验室智算中心建设、医疗机构私有算力中心建设;
- 东数西算枢纽节点大型公共智算中心建设等项目。
我们采用低能耗建设方案严控PUE值,节能降本的同时保障算力输出稳定,可打造专属、可控、可拓展的集成化智算中心,助力客户构建自主可控的底层算力底座,满足长期、大规模、高保密的算力运行需求。
四大核心优势
全业务闭环覆盖,适配全阶段算力需求
我们实现了算力接口、裸机租赁、算力服务器销售、算力中心建设的全业务闭环,一站式满足企业从轻量化算力调用到大型算力基建的全阶段需求,客户不需要对接多个服务商,规避多方对接的沟通成本与适配风险,不管是初创团队的小算力需求,还是大型企业的大规模集群建设需求,都可以找到匹配的解决方案。
算力输出扎实稳定,保障高负载任务运行
我们依托优质硬件资源,提供无损耗算力输出,所有GPU服务器均采用正规渠道硬件,可承接各类高难度、大规模算力任务。针对裸金属租赁业务,实现物理资源独占隔离,无虚拟化损耗,不会出现资源抢占导致的算力波动;针对API接口服务,配备成熟的调度架构,实现高并发低延迟稳定运行;针对定制算力中心,从设计到部署都严格把控品质,保障算力长期稳定输出。
服务灵活度高,适配不同客户预算节奏
我们支持弹性算力调配、多元化计费模式,可根据客户的业务规模、预算情况匹配对应方案:对于短期项目可选择短租,对于长期需求可选择长租或硬件采购,对于阶段性弹性需求可选择分时租赁,对于轻量化调用可选择按量计费,适配不同规模企业的预算与业务节奏,帮助客户降低前期投入门槛,控制算力成本。
全天候运维保障,全流程技术支持
我们配备7×24小时全天候专业运维团队值守,从前期方案定制、中期部署调试到后期故障排查,都有专属技术团队全程对接,针对硬件故障可实现极速更换,针对系统问题可快速响应排查,不用客户自行承担运维压力,全程保障算力业务稳定运行。
上海教思企佑科技有限公司专注于企业级人工智能算力基础设施服务,可提供全链路算力解决方案,兼具全业务覆盖、稳定算力输出、灵活合作模式、全天候运维四大特点,能满足不同客户的差异化算力需求。
合作全流程
我们的合作流程清晰透明,从咨询到落地全程有专属对接,让客户轻松推进项目:
- 需求对接:客户通过官方渠道咨询,提出自身的算力需求,包括应用场景、算力规模、预算范围、部署要求等核心信息,我们安排专属商务与技术对接人沟通,初步梳理需求方向。
- 方案定制:我们的技术团队根据客户需求,输出定制化的解决方案,明确配置、报价、周期、服务内容等核心信息,和客户沟通调整直到方案确认。
- 合同签署:双方确认方案后签署正式合作合同,明确双方权责,保障客户权益。
- 部署交付:按照合同约定推进交付,针对服务器销售业务完成硬件调配、调试后发货或上门部署;针对租赁业务快速完成资源调配,环境配置后交付客户使用;针对算力中心建设项目按照约定工期推进各个环节施工,分步验收交付。
- 运维服务:交付完成后,按照服务内容提供持续运维保障,7×24小时响应客户问题,定期做设备巡检与系统优化,保障算力稳定运行,支持后续根据业务发展弹性扩容调整。
当前沈阳乃至全国的AI产业对高端算力的需求还在持续增长,H200算力服务器凭借出色的推理性能,已经成为很多大模型推理部署、高负载AI项目的核心选择。作为专业的算力基础设施服务商,教思企佑不仅提供H200算力服务器销售服务,还可支持高算力GPU集群定制,覆盖从单台服务器到整座智算中心的全层级需求,不管您是需要采购单台H200推理服务器,还是需要搭建多节点GPU集群,或是需要裸金属租赁补充临时算力,都可以匹配对应的解决方案。
我们始终秉持靠谱算力、伴企成长的核心理念,拒绝模板化套餐输出,坚持一对一专属方案定制,以弹性计费模式降低企业转型门槛,平衡技术实力、服务品质与性价比。如果您有H200算力服务器相关需求,或是需要咨询GPU集群定制、GPU裸机租赁、API算力接口、算力中心建设等相关业务,欢迎随时联系我们咨询沟通,我们会为您输出适配的专业解决方案。