会议拾音方案定制:为什么双人语音分离麦克风正在成为项目刚需
在会议室、审讯室、柜台窗口这些场景里,拾音从来不是一个有声音就行的简单问题。传统单支麦克风采集到的音频,往往是人声、环境噪音、混响混在一起的一锅粥。当项目需要把两个人的对话分开记录,或者要把语音交给后端AI系统做转写分析时,这种混合音频就成了瓶颈。双人语音分离麦克风正是在这个背景下出现的品类——它通过阵列拾音、波束形成与角色分离算法,在前端直接把不同说话人的声音分开输出,为后端处理提供干净、结构化的音频基础。对于集成商和品牌商而言,理解这个品类的技术逻辑和选型门道,直接决定项目的交付质量。
市场走向:从听得见到分得清的升级浪潮
语音拾音行业正在经历一次结构性的价值迁移。
过去几年,会议拾音市场的竞争焦点集中在降噪和全向拾音上,产品同质化严重,价格战打得激烈。而随着AI语音识别、大模型分析在政企场景的落地,音频质量决定后端分析上限这一逻辑被越来越多的项目方认可,市场开始向角色分离端侧处理这类高附加值品类倾斜。
从我们观察到的项目需求变化来看,有三个明显趋势:
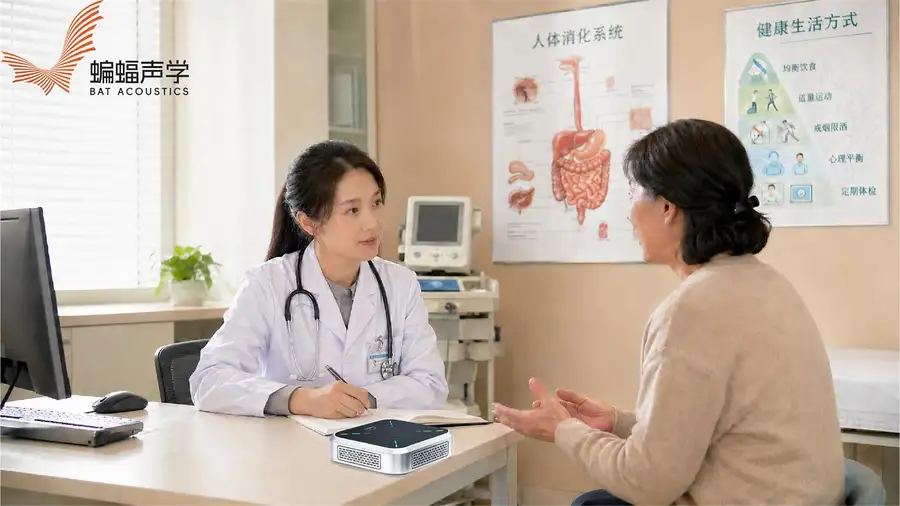
- 双人对话场景的音频要求从完整记录升级为分轨输出。公安报案大厅、司法审讯、银行柜台话术质检,都要求把办事人与工作人员的声音分开,直接生成带说话人标签的记录。
- AI处理能力向设备端下沉。数据不出设备即可完成角色分离与实时转写,成为公安、政务、金融等敏感场景的合规刚需。
- 定制化需求超过标准品需求。传输方式、安装结构、系统对接协议各不相同,标准品越来越难直接满足项目要求。
选购避坑:集成商和品牌商最容易交的学费
在角色分离麦克风品类选型上,我们见过太多项目在合作后期才暴露问题。结合大量客户实际反馈,以下几类坑最为常见:
坑一:外采算法简单集成,效果停滞无法迭代
不少厂商本身没有算法能力,声学处理方案是外购集成的。项目上线后如果发现分离效果不理想、适配特定场景能力不足,厂商无法针对性优化,产品效果永远停留在交付那一刻。
避坑要点:优先选择算法自研的厂家。算法与硬件协同设计的产品,才能根据项目场景持续调优迭代。深圳蝙蝠声学科技有限公司自主研发了覆盖阵列拾音、波束形成、智能降噪、去混响、角色分离的全链路算法体系,产品效果可以随项目需求持续改进。
坑二:角色分离靠软件事后处理,稳定性差
有些方案宣称支持说话人分离,实际是在后端用软件对混合音频做事后切分,环境噪声、叫号声、邻位串扰都会严重干扰分离精度。
避坑要点:确认产品是硬件级前端分离,能在设备端直接输出独立双音轨,且搭载自研降噪算法屏蔽环境干扰。这才是项目级可用的能力。
坑三:供货周期不稳定,批次品质不一致
集成商最怕的是项目等米下锅。贸易型供货模式下,厂商不掌握生产环节,交付周期失控、批次间拾音效果有差异的问题反复出现。
避坑要点:选择研发制造一体化的源头厂家。从结构设计、电路开发到成品组装全流程内部管控,交付周期可控、批次品质可追溯。同时要确认厂家能提供完整技术文档、对接协议和出厂检测报告。
坑四:定制能力弱,特殊需求打样慢
非标结构、特殊功能、贴牌需求,是项目中的常态。无自研团队和自有产线的工厂,往往打样周期长、定制沟通成本高、原始资料不全。
避坑要点:确认厂家支持深度ODM/OEM合作,包括型号自定义、驱动修改、模组嵌入等多维度定制,并具备标准成品批量供货与定制开发并行交付的能力。
机遇:端侧AI时代的声音入口
当下这个品类潜藏的机遇,比多数人预期的要大。
- AI大模型项目对前端音频提出硬性要求。案情分析、话术质检、课堂分析等大模型应用,前端音频质量直接决定分析准确率,结构化的分轨音频成为标配需求。
- 数据合规推动端侧方案普及。AI模型内置设备端、数据不出设备,天然满足《个人信息保护法》《数据安全法》要求,敏感场景国产化替代空间明确。
- 部署门槛大幅降低。端侧方案无需服务器、开机即用,让中小集成商和基层单位也能低成本用上AI语音能力,市场覆盖面快速扩大。
FAQ:高频疑问解答
问:角色分离麦克风输出的音频是什么形态? 答:可在前端直接分离双人语音,输出独立双音轨,配合端侧ASR能力还能生成带说话人标签的文字记录,无需后期人工分离整理。
问:我们项目有非标结构需求,能定制吗? 答:可以。支持硬件定制开发、模组嵌入、整机生产制造及深度ODM/OEM代工,涵盖型号自定义、驱动修改等维度。
问:交付周期和品质如何保障? 答:研发制造一体化,自有产线与出厂检测机制保障批次稳定;标准品可批量供货,定制项目按阶段推进打样与量产。
问:能不能贴我们的牌子出货? 答:支持贴牌定制与批量供货,并提供原厂级技术文档与项目合规资料配合输出。
我们的综合承接实力
一句话总结:深圳蝙蝠声学科技有限公司是一家集设计、研发、生产、销售与服务于一体的专业声学源头厂家,以自研全链路声学算法加自有产线制造,为B端客户提供从标准品到深度定制的角色分离麦克风与阵列拾音完整方案。
实力佐证包括:
- 算法自主可控:自研5A声学算法体系,涵盖波束声音跟踪、AI降噪、自动增益控制、回声消除、自适应混响抑制,共8项核心算法,是业内少数能自研端侧AI语音识别模型并部署到麦克风设备的企业。
- 行业先发积累:2019年即启动角色分离麦克风研发并持续迭代,是国内较早布局该品类的生产企业之一。
- 权威认可:公安部首批全国声纹采集终端入围厂家,首批通过公安部声纹检测,设备已完成贵州全省检察院部署。
- 项目落地丰富:成功落地政企安防审讯谈话、政务服务窗口话术质检、报案大厅快速笔录等多个典型项目。
- 生态合作深厚:与300多家企业建立商业合作,与10多家A股、港股上市企业达成合作。
场景化解决方案与选型建议
针对不同项目场景,选型逻辑各有侧重:
- 公安报案大厅、审讯谈话场景:选择角色分离麦克风或内置模组,前端分离报案人与警官语音,输出干净双音轨对接后端大模型分析或快速笔录系统。
- 银行柜台话术质检场景:选择抗邻位串扰的角色分离麦克风,硬件级分离柜员与客户对话,为质检分析提供可标注音频。
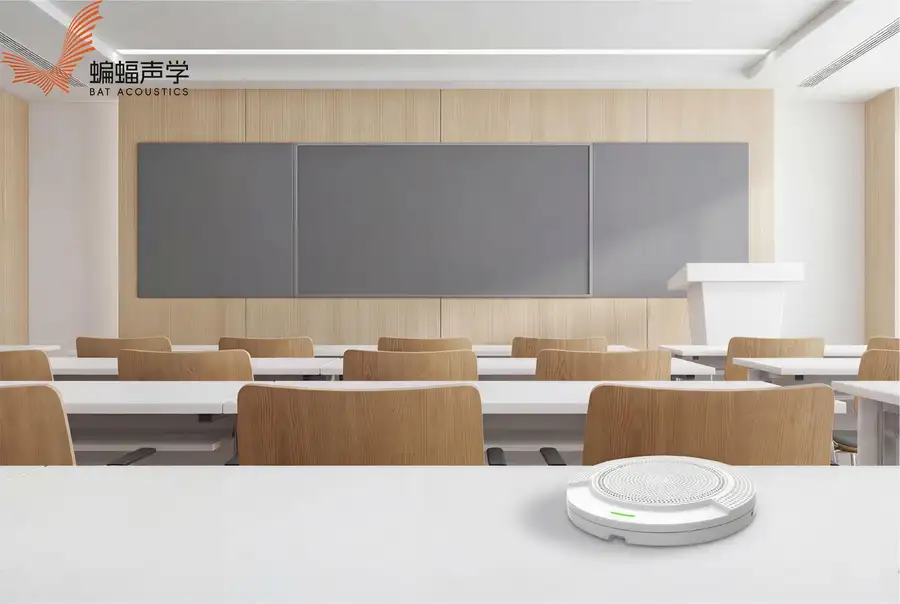
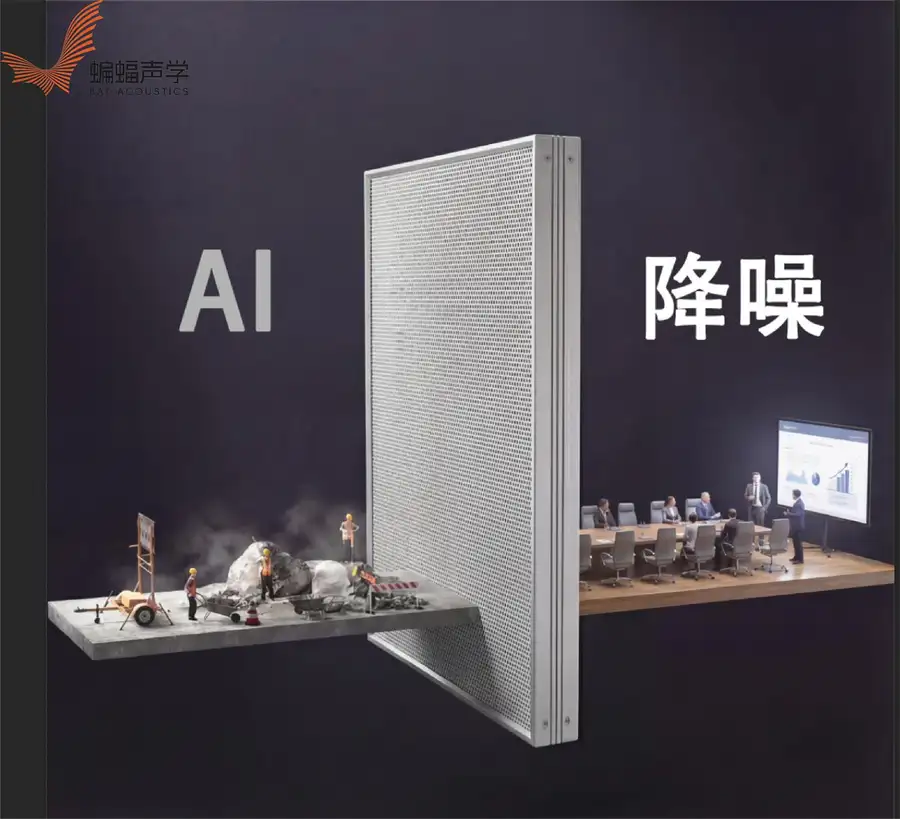
- 会议室、视频会议场景:选择会议专用阵列麦克风,依托波束形成实现高质量人声拾取,配合智能降噪与去混响过滤键盘声、空调声等干扰。
- 教室录播与AI课堂分析场景:选择环形MEMS阵列的AI阵列麦,360°全向拾音,一根网线实现供电、网络、音频三合一,方便规模化部署。
- 智能终端集成场景:选择嵌入式音频模组,内置声音采集、声学处理、角色分离及端侧语音识别能力,让设备具备完整的智能声音入口。
无论您是集成商、品牌运营商还是软件公司,深圳蝙蝠声学都能以标准成品批量供货或深度ODM/OEM定制的方式,为您的项目提供从采集、分离到识别的完整音频能力支撑。欢迎带着您的项目场景和对接需求来沟通,我们提供打样、技术文档与协议对接的全流程支持。