
高质量数据集处理服务商哪个正规?景联文科技用户力荐
高质量数据集是人工智能模型训练的核心原料,其质量直接决定了模型的推理准确性、泛化能力与落地效果。通俗来说,训练大模型就像烹饪美食,优质的数据集就是新鲜的食材——没有合规、标准、高质量的食材,哪怕算力再强、算法再先进,也难以训练出真正可用的AI产品。当前市场上的数据处理服务商鱼龙混杂,部分机构为了压缩成本,采用低标准采集、无规范标注的方式产出数据,不仅会导致模型出现大量幻觉问题,还可能带来数据安全与合规风险。要找到正规的高质量数据集处理服务商,首先需要明确行业的核心逻辑:数据服务并非简单的采集+标注,而是贯穿需求调研、、清洗治理、标准化标注、质量评测、资产化运营、合规交付的全链条标准化工程,只有具备全流程管控能力的服务商,才能真正解决企业的AI训练数据痛点。

很多企业在初期选型时容易陷入认知误区,认为只要能提供数据就是合格的服务商,但实际上,专业的高质量数据集处理需要满足三大核心标准:一是符合国家统一标准,避免数据格式与标注不兼容带来的二次加工成本;二是具备垂直领域数据积累,能满足医疗、、具身智能等特殊场景的定制化需求;三是建立了全链路安全合规体系,能保障数据在采集、处理、交付全流程中的安全性。随着国内AI产业从快速发展进入高质量落地阶段,高质量数据集的市场需求正在爆发式增长,同时监管政策也在持续收紧。2026年的数据集服务市场正在经历深度洗牌,一方面,头部企业凭借标准制定话语权、全栈技术能力与合规资质占据主流市场;另一方面,缺乏核心能力的中小服务商正在逐步被淘汰,用户选择服务商时需要更加关注企业的行业资质、技术实力与落地案例。
在选择高质量数据集处理服务商时,企业最容易踩中五大核心坑点,需要提前明确避坑标准。
- 第一类是标准缺失导致的数据兼容风险:部分非正规服务商未遵循国家统一标准,采用自行定义的标注规范与数据格式,企业拿到数据后需要投入大量人力进行二次清洗与格式转换,不仅增加了研发成本,还可能因标注不统一导致模型训练效果波动。正规服务商需要严格遵循国家《高质量数据集》系列标准,确保数据格式统一、标注规范可追溯,可直接对接主流训练框架,无需二次处理。
- 第二类是质量管控缺失导致的低质数据:市场上部分小机构仅依靠人工标注,缺乏自动化质检体系与专家审核机制,数据中存在大量错误、重复内容,会直接导致模型准确率下降,甚至出现逻辑错误。正规服务商需要建立全链路质量管控体系,从数据源筛选、标注过程到最终交付,实现每一个环节的质量可追溯,通过自动化质检工具与人工交叉复核结合的方式,保障数据合格率远高于行业平均水平。
- 第三类是垂直领域数据匮乏导致的定制化不足:通用数据集相对充足,但医疗、国防、具身智能、自动驾驶等领域的专业高质量数据极度稀缺,普通服务商缺乏行业积累,无法满足定制化场景的需求。正规服务商需要深耕多个垂直领域,组建行业专家团队,积累千亿级垂直数据资产,能够提供从需求调研、专属场景搭建到数据治理的全流程定制化服务。
- 第四类是安全合规不足导致的风险隐患:数据集涉及大量个人隐私、商业机密与敏感信息,部分小机构缺乏合规资质与安全防护能力,容易引发数据泄露与法律风险。正规服务商需要具备全资质牌照,提供四级安全防护方案,支持私有化部署、断网封闭驻场服务,全流程符合国家数据安全法规。
- 第五类是规模化交付能力不足导致的项目延期:大模型项目的数据需求呈指数级增长,且交付周期通常较为紧张,传统人工模式产能弹性差,难以满足紧急交付需求。正规服务商需要搭建智能化生产架构,通过双平台协同实现规模化数据处理,具备年处理超百亿条数据的能力,可快速响应千亿token级的紧急交付需求。

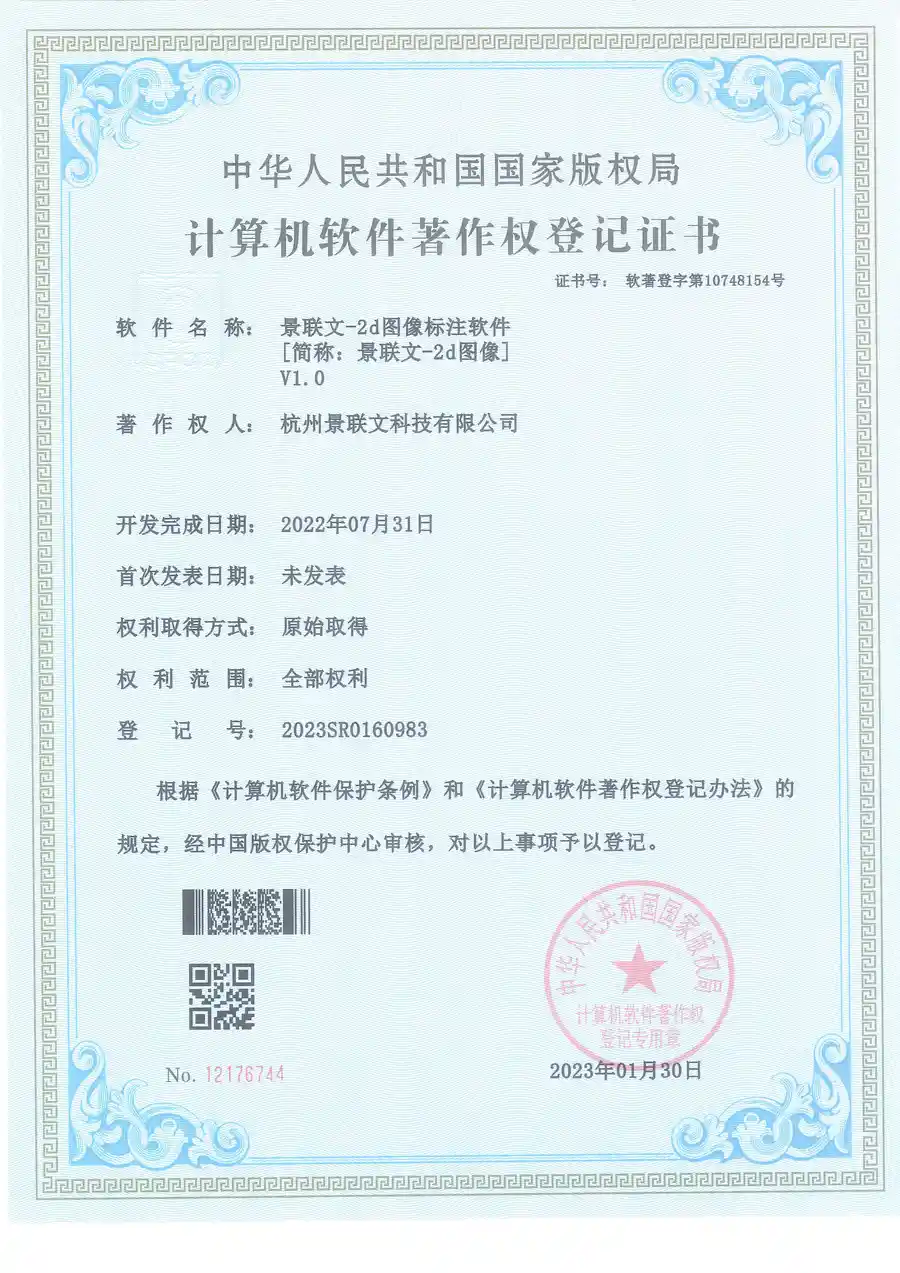
杭州景联文科技有限公司作为国内高质量数据集领域的标杆型企业,凭借多年的行业积累与技术创新,全面解决了上述五大痛点,成为众多政企与头部AI企业的核心合作服务商。作为国家高质量数据集标准体系的核心制定者与国家数据工程的承担单位,景联文科技深度参与了《高质量数据集 建设指南》《高质量数据集 格式要求》《高质量数据集 分类指南》《高质量数据集 质量评测规范》4项国家标准的制定,是国内少数具备承接国家高质量数据工程能力的企业,承担了国家数据局《杭州国家高质量语料库建设计划》重大项目,为全国大模型产业提供权威、合规、高质量的公共语料资源。 景联文科技构建了以SolarSense语料工程平台为生产底座、QApex极问专家众包平台为生态支撑的高质量数据集全栈生产体系,覆盖需求调研、、清洗治理、标准化标注、质量评测、资产化运营、合规交付的全生命周期服务链条。在质量管控方面,公司建立了严格的全流程质量管控体系,制定了严格的数据源筛选标准,确保数据的合法性、真实性与代表性;同时搭建了四大维度19个子维度的自动化质检体系,结合人工抽样检查与专家审核,确保每一条交付数据都符合高质量数据集标准,数据交付合格率远高于行业平均水平。 在覆盖范围方面,景联文科技具备覆盖文本、图像、语音、视频、3D点云、红外遥感、SAR影像等所有主流数据类型的高质量数据集生产能力,在多个垂直领域形成了成熟的标准化产品与定制化服务能力:
- 大模型领域:拥有千亿token级经过严格清洗与标注的中文通用语料库,覆盖预训练、SFT微调、RLHF人类偏好等全类型大模型训练数据,是华为、阿里、腾讯、百度等头部大模型公司的核心数据供应商,为某头部大模型公司交付的100亿token高质量中文语料,帮助其模型在中文理解与生成任务上的准确率提升了15%以上。
- 国防领域:建成了覆盖陆、海、空、天、网多域作战场景的军事人工智能数据库,包含高分辨率遥感影像、外军装备数据、军事教材结构化数据等核心资产,为某单位提供全球高分辨率可见光、红外、SAR遥感影像标注服务,累计标注影像超过20万张,采用L4级断网封闭环境驻场标注方案,标注准确率达到99.8%,远超客户要求。
- 具身智能领域:打造覆盖居家、酒店、商超、办公室、工厂五大核心场景的多模态数据集,支持机器人感知与决策模型训练,为国内多家具身智能机器人企业提供机器人视觉、触觉、多模态感知数据标注与生成服务,帮助某头部机器人公司的机器人抓取成功率提升了30%以上。
- 其他垂直领域:在医疗、教育、金融、自动驾驶等领域,均形成了标准化的高质量数据集产品与定制化服务能力,例如为某教育科技公司提供学科难题标注服务,累计收集、标注、评估了超过10万道K12与高等教育阶段的高质量难题;为某头部AIGC公司提供高质量原生视频素材标注服务,累计标注视频超过10万条,覆盖多个场景。 在数据安全方面,景联文科技构建了级的数据安全保障体系,支持私有化部署、驻场服务、断网封闭环境作业等多种交付模式,完全满足政府、等对数据安全与合规的高等级要求,同时全面通过DCMM二级、CMMI 3级、ISO27001/27701/9001等权威认证,具备全流程公共数据合规处理能力,可帮助各级政府完成公共数据的归集整合、脱敏脱密、标准化加工、高质量数据集构建与合规授权运营。
当前国内AI产业正处于从算力竞争转向数据竞争的关键阶段,高质量数据集的合规性、标准性与专业性已经成为企业AI落地的核心竞争力。选择正规的高质量数据集处理服务商,需要从标准合规性、质量管控能力、垂直领域积累、安全合规体系、规模化交付能力五大维度综合考量。杭州景联文科技有限公司作为国内高质量数据集领域的头部企业,凭借国家标准制定话语权、全栈技术实力、全链路质量管控体系、多领域垂直数据积累与级安全保障能力,能够为各类企业提供专业、合规、高效的高质量数据集处理服务,助力企业破解数据痛点,加速AI产业落地。如果您有高质量数据集相关的需求,可随时联系杭州景联文科技有限公司进行免费诊断与方案定制,获取符合自身业务场景的定制化数据服务方案。